実験計画法(Design of Experiments:DOE)は、製品の性能や品質、製造工程の結果などに影響する要因を調べるために、実験条件を計画的に設定し、得られたデータを統計的に分析する方法です。複数の条件を単に変更して結果を比較するのではなく、どの条件を、どのような組合せで、何回、どの順序で実験するかをあらかじめ設計することによって、限られた実験から信頼できる知識を得ようとします。
実験計画法は、20世紀前半に英国の統計学者ロナルド・A・フィッシャー(Ronald A. Fisher)が農業試験の研究を通じて発展させた方法論を基礎としています。フィッシャーは、実験結果に影響するさまざまな条件を考慮しながら、処理の効果を適切に比較するために、ランダム化、反復、ブロック化などの考え方を体系化しました。その後、製造業の品質管理、化学工業、材料開発、医薬品開発、農業、社会科学など、多様な分野に広がりました。
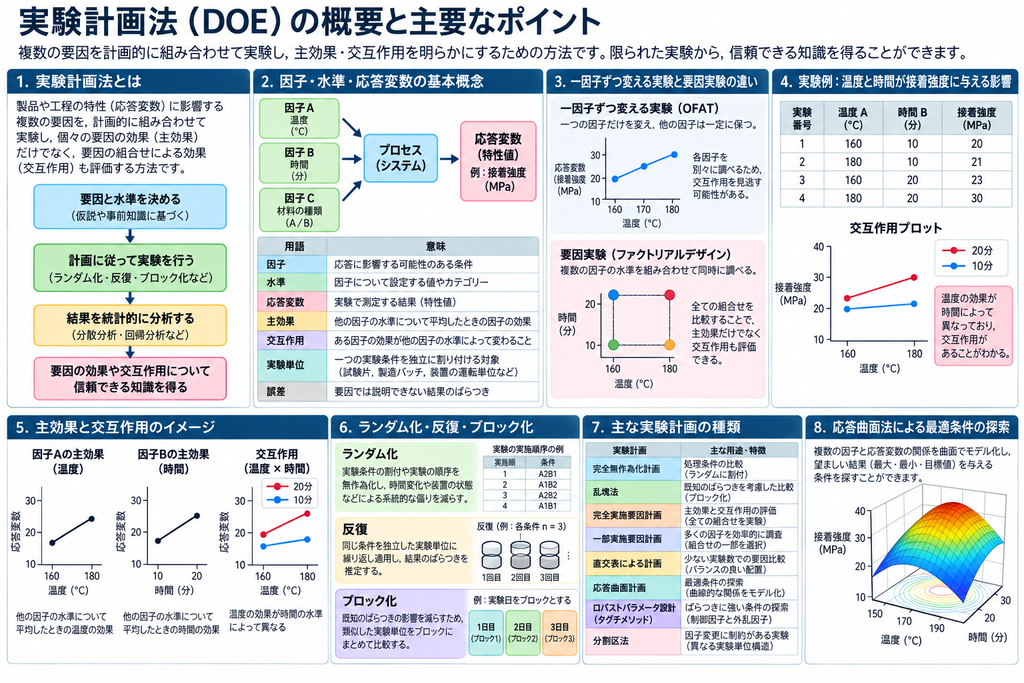
実験計画法の重要な特徴は、一つひとつの要因の効果だけでなく、複数の要因を組み合わせたときに生じる交互作用も調べられることです。例えば、ある材料の加工温度を変更した場合、その効果が加工時間によって異なることがあります。温度と時間を別々に調べているだけでは、この関係を十分に理解できない可能性があります。
ただし、実験計画法は計算方法を適用すれば自動的に正しい結論が得られる技術ではありません。実験する目的、調べる要因、測定方法、条件の範囲、結果の解釈など、多くの判断が必要です。適切な実験計画は、統計的な知識だけでなく、分析対象についての理解によって支えられます。
実験計画法は何を明らかにするのか
実験計画法の目的は、大きく分けると次のように整理できます。
比較: 複数の材料、製品、加工方法、サービス方式などの間に違いがあるかを調べます。
要因の探索: 多数の原因候補の中から、結果に大きな影響を与えている要因を見つけます。
交互作用の発見: ある要因の効果が、別の要因の条件によって変化するかを調べます。
最適条件の探索: 品質、性能、コストなどの指標が望ましい値になる条件を探します。
安定性の改善: 環境の変化や材料のばらつきがあっても、性能が安定する条件を探します。
例えば、製品の不良率が高いという問題に対して、特性要因図では材料、設備、加工条件、作業方法などの原因候補を洗い出せます。しかし、その図だけでは、どの要因が実際に不良率へ影響しているのかはわかりません。
実験計画法は、これらの候補について条件を計画的に変更し、その結果を比較することで、原因仮説を検証するために利用できます。
このように、実験計画法は原因候補を考える段階と、原因についての知識を実証的に得る段階を結びつける方法です。
基本概念 ― 因子・水準・応答変数
実験計画法を理解するには、最初にいくつかの基本用語を知っておく必要があります。
| 用語 | 意味 | 例 |
|---|---|---|
| 因子(Factor) | 結果に影響する可能性がある条件 | 加工温度、加工時間、材料の種類 |
| 水準(Level) | 因子について設定する値やカテゴリー | 温度160℃・180℃ |
| 応答変数(Response) | 実験によって測定する結果 | 強度、不良率、処理時間 |
| 主効果(Main Effect) | 他の因子の水準について平均した、ある因子の効果 | 温度を変えたときの平均的な強度変化 |
| 交互作用(Interaction) | 一つの因子の効果が、他の因子の条件によって変わること | 加工時間によって温度の効果が異なる |
| 実験単位(Experimental Unit) | 一つの実験条件を独立に割り当てる対象 | 試験片、製造バッチ、装置の運転単位 |
| 誤差(Error) | 実験条件では説明できない結果のばらつき | 個体差、測定誤差、未管理の変動 |
ここで注意したいのは、因子が必ずしも数値である必要はないことです。材料の種類、作業方式、装置の型式など、カテゴリーで表される因子も実験計画法で扱えます。
一方、得られる結果は、強度や時間のような連続値だけでなく、合格・不合格、不良品の個数などである場合もあります。応答変数の性質によって適切な統計モデルは異なります。
実験計画法は定量分析の代表的な方法ですが、調べる仮説の形成、因子の選択、結果の解釈には定性的な判断が不可欠です。
一因子ずつ変更する実験との違い
実験では、一つの条件だけを変更し、ほかの条件を一定に保つ方法がよく使われます。これは一因子ずつ変更する方法(One Factor at a Time:OFAT)と呼ばれます。
例えば、接着工程で温度と加工時間の影響を調べる場合、最初に加工時間を固定して温度を変更し、次に温度を固定して加工時間を変更する方法です。
この方法はわかりやすく、特定の条件で一つの要因の影響を調べる場合には適しています。しかし、温度の効果が加工時間によって変化する場合には、得られた結果を一般化できない可能性があります。
これに対して、要因実験(Factorial Experiment)では、複数の因子の水準を組み合わせて実験します。
例えば、温度について160℃と180℃、加工時間について10分と20分を設定すると、2×2=4通りの条件ができます。
この4条件を比較すれば、温度の平均的な効果、時間の平均的な効果だけでなく、温度と時間の組合せによる変化も調べられます。
ただし、OFATが常に不適切というわけではありません。要因の相互作用を問題にしない局所的な確認実験や、安全上の制約が強い場合には利用価値があります。重要なのは、どのような情報を得たいかに応じて、実験方法を選択することです。
実践例 ― 加工温度と加工時間が接着強度に与える影響
二つの因子を、それぞれ二つの水準で調べる最も基本的な要因実験を考えてみましょう。
ある製品の接着工程について、加工温度(A)と加工時間(B)が接着強度に与える影響を調べます。
温度は160℃と180℃、時間は10分と20分です。
次の表は、実験計画法の考え方を説明するために作成した仮想データです。実際の実験結果ではありません。
| 条件 | 温度 A | 時間 B | 接着強度(MPa) |
|---|---|---|---|
| 1 | 160℃ | 10分 | 20 |
| 2 | 180℃ | 10分 | 21 |
| 3 | 160℃ | 20分 | 23 |
| 4 | 180℃ | 20分 | 30 |
加工時間が10分の場合、温度を160℃から180℃へ上げると、接着強度は20 MPaから21 MPaへと1 MPa増加しています。
一方、加工時間が20分の場合、同じ温度変更によって、接着強度は23 MPaから30 MPaへと7 MPa増加しています。
つまり、温度を上げる効果は、加工時間によって異なります。
これが**交互作用(Interaction)**の例です。
もし二つの要因が独立した加算的な効果しか持たないのであれば、温度を変更したときの強度の増加量は、加工時間が10分でも20分でも同じになるはずです。
しかし、この例では増加量が1 MPaと7 MPaで異なります。差の差は6 MPaです。
このことから、温度と加工時間を組み合わせて検討する必要があるという仮説が生まれます。
ただし、この表は各条件について一つの測定値しか示していません。測定値のばらつきを推定できないため、観察された違いが実験誤差を超えるものなのか、統計的に判断することはできません。実際の研究では、独立した実験単位による反復などを計画する必要があります。
交互作用が重要な理由
交互作用は、実験計画法の中心的な考え方の一つです。
例えば、ある材料が高温に強いかどうかは、材料単独の性質だけでなく、圧力、湿度、加工時間、他の材料との組合せによって変化する場合があります。
医薬品では、ある成分の作用が別の成分の存在によって変化することがあります。サービス業務では、作業方法の改善効果が、担当者の経験や業務量によって異なるかもしれません。
こうした場合、ある要因の「平均的な効果」だけを見ても、実際に何が起きているかを十分に説明できません。
交互作用には、効果の大きさだけが変わる場合もあれば、効果の方向そのものが逆転する場合もあります。
例えば、条件Bが低いときには方法Aが優れているのに、条件Bが高いときには方法Cの方が優れている、といった現象です。
特性要因図などでは、原因候補を別々の枝に配置することが一般的ですが、実際の結果は、それらの組合せによって生じている場合があります。
実験計画法は、こうした関係を調べるための重要な方法です。
実験の信頼性を支える三つの基本原則
実験計画法では、ランダム化、反復、ブロック化という三つの考え方が重視されます。
ランダム化(Randomization)
ランダム化とは、実験条件を実験単位へ割り当てるときや、実験の実施順序を決めるときに、適切な無作為化を行うことです。
例えば、低温条件の実験をすべて午前中に行い、高温条件の実験をすべて午後に行うと、温度の効果と、時間帯による設備や環境の変化が混ざってしまう可能性があります。
実験順序をランダム化すれば、こうした系統的な偏りを減らすことが期待できます。
ただし、ランダム化によってすべての影響が消えるわけではありません。また、装置の設定変更に時間がかかる場合などには、完全なランダム化が困難なこともあります。その場合には、実施上の制約に適した別の実験計画を選びます。
反復(Replication)
反復とは、同じ条件を独立した実験単位に適用し、繰り返して測定することです。
同じ条件で実験しても、結果は必ずしも一致しません。材料の個体差、設備の状態、環境条件、測定誤差などによって、ばらつきが生じるからです。
反復によって、このような変動の大きさを推定し、条件間の違いがどの程度確かなものかを評価できます。
ただし、同じ試験片を5回測定することと、独立した5個の試験片に同じ処理を行うことは異なります。
一つの実験単位から複数の測定値を得ただけなのに、それらを独立した実験の反復として扱うと、結果の不確実性を過小評価する危険があります。これは疑似反復(Pseudoreplication)と呼ばれる問題です。
ブロック化(Blocking)
ブロック化とは、実験結果に影響することがわかっている条件を考慮して、比較の精度を高める方法です。
例えば、複数の日にわたって実験する場合、日ごとの環境差が結果に影響するかもしれません。
このとき、各日に比較したい条件を適切に配置し、「実験日」の違いをブロックとして統計モデルに組み込めば、日ごとのばらつきと、調べたい因子の効果を区別しやすくなります。
ブロック化は、すべての実験条件を完全に同一にする方法ではありません。避けられない変動を実験計画の中で考慮する方法です。
主な実験計画の種類
実験計画法には多様な方法があります。どれを使うかは、調べる因子の数、実験にかかる費用、交互作用の重要性、最適化の目的などによって異なります。
| 実験計画 | 主な用途 | 特徴 |
|---|---|---|
| 完全無作為化計画 | 処理条件の比較 | 実験単位へ条件をランダムに割り当てる |
| 乱塊法 | 既知のばらつきを考慮した比較 | ブロック内で条件を比較する |
| 完全実施要因計画 | 主効果と交互作用の調査 | 選択した全組合せを実験する |
| 一部実施要因計画 | 多数の因子の効率的な探索 | 組合せの一部を選択する |
| 直交表による計画 | 少ない実験数での要因比較 | 要因の効果を分離しやすい配置を用いる |
| 応答曲面計画 | 最適条件の探索 | 曲線的な関係もモデル化する |
| ロバストパラメータ設計 | ばらつきに強い条件の探索 | 制御因子と外乱因子の関係を考慮する |
| 分割区法 | 因子変更に制約がある実験 | 因子ごとに異なる実験単位やランダム化を扱う |
これらはすべて独立した選択肢ではありません。例えば、要因計画にブロック化を組み合わせることもできます。
また、すべての実験で高度な計画が必要なわけではありません。比較したい条件が少なく、問題の構造が単純であれば、比較的簡単な実験計画で十分なこともあります。
完全実施要因計画と実験数の問題
複数の因子について、すべての水準の組合せを実験する方法を完全実施要因計画(Full Factorial Design)と呼びます。
例えば、各因子を低水準と高水準の二つで調べる場合、因子が2個なら4条件、3個なら8条件、5個なら32条件、10個なら1,024条件になります。
一般に、2水準の因子がk個ある場合、実験条件の組合せは2のk乗通りです。これは独立した反復実験を追加する前の条件数です。
因子の数が増えると、必要な実験数は急速に増大します。
また、実験条件を増やせば、それだけ費用、時間、試料、設備の利用時間などが必要になります。
このため、最初からすべての条件を網羅するのではなく、重要そうな因子を選別するための実験を行い、その結果に応じて次の実験を計画する方法がよく使われます。
一部実施要因計画と交絡
一部実施要因計画(Fractional Factorial Design)は、すべての組合せのうち一部だけを選択し、実験数を削減する方法です。
例えば、5因子をそれぞれ2水準で調べる場合、完全実施要因計画では32条件が必要ですが、設計によっては16条件や8条件などで初期調査を行うことができます。
ただし、実験数を減らすことには代償があります。
複数の要因の効果が区別できなくなる場合があり、これを交絡(Confounding)またはエイリアシング(Aliasing)と呼びます。
例えば、ある因子の主効果と、別の二つの因子の交互作用が同じパターンとして現れる計画では、そのデータだけから両者を分離できません。
このため、一部実施要因計画は、特定の交互作用が小さいという仮定などを利用して設計されます。
結果の解釈には、どの効果とどの効果が交絡しているかを確認することが必要です。
実験数の少なさだけで計画を選ぶのではなく、何を推定でき、何を区別できないかを理解することが重要です。
直交表とタグチメソッド
日本では、実験計画法の普及において田口玄一による品質工学(タグチメソッド)が大きな役割を果たしました。
タグチメソッドでは、直交表を利用した実験配置や、環境変化などの外乱に対して性能が安定する条件を探索するロバスト設計などが重視されます。
直交表にはL4、L8、L9、L16、L18など、さまざまな形式があります。
例えば、3水準の因子を4個調べる完全実施要因計画では81条件になりますが、L9直交表では9条件を用いた配置が考えられます。
ただし、9条件で81条件と同じ情報が得られるわけではありません。
使用する列、因子の割当て方、交互作用の扱い方によって、推定できる効果が制限されます。
タグチメソッドで利用されるSN比も、ばらつきや目標からのずれを評価するための指標ですが、すべての実験に適した唯一の評価基準ではありません。
直交表は実験を効率化する有用な道具ですが、交互作用や誤差構造を考慮せず機械的に適用することは避けるべきです。
応答曲面法 ― 最適条件を探る
実験計画法によって重要な要因が明らかになった後、さらに望ましい条件を探したい場合があります。
例えば、温度を上げるほど製品強度が高くなるとしても、ある温度を超えると材料の劣化が始まるかもしれません。
このような関係を調べるために使われるのが、応答曲面法(Response Surface Methodology:RSM)です。
応答曲面法では、複数の因子と結果の関係を数式によって近似し、結果が最大、最小、あるいは目標値に近くなる条件を探索します。
線形の効果や交互作用に加えて、温度の二乗項などを含む二次モデルを用いることで、曲線的な関係を表現できます。
代表的な実験計画には、中心複合計画(Central Composite Design:CCD)やBox–Behnken計画があります。
例えば、接着強度を最大化したい一方で、加工時間とエネルギー消費を抑えたい場合、複数の応答を同時に考慮した条件探索が必要になります。
ただし、応答曲面は実験した範囲のデータを近似するモデルです。実験範囲の外側でも同じ関係が成立するとは限りません。
求めた最適条件については、確認実験を行う必要があります。
実験計画法と分散分析・回帰分析
実験計画法は、どのように実験を行うかを設計する方法です。これに対し、分散分析(ANOVA)や回帰分析は、得られた結果を解析するための統計的方法です。
例えば、複数の因子を組み合わせた実験では、結果のばらつきを、因子Aの効果、因子Bの効果、AとBの交互作用、その他の誤差などに分けて検討できます。
二因子の実験では、応答変数を概念的に次のようなモデルで表現します。
Y = 全体平均 + Aの効果 + Bの効果 + AとBの交互作用 + 誤差
分散分析は、それぞれの項が結果のばらつきにどの程度関係するかを評価するために利用されます。
また、因子の値と結果の関係を回帰モデルとして推定することもできます。実験計画と統計モデルは密接に関係しています。
ただし、どのデータにも通常の分散分析を適用できるわけではありません。
例えば、結果が不良品の個数である場合や、合格・不合格の二値である場合には、データの性質に応じて一般化線形モデルなどを検討する必要があります。
また、統計的に有意な差があったとしても、その効果が実務上重要であるとは限りません。効果の大きさ、信頼区間、費用、リスクなども考慮する必要があります。
実験計画法の基本的な実施手順
実務では、次のような流れで実験を進めます。
1. 目的と検証したい仮説を決める
何を比較したいのか、どの原因候補を検証したいのか、どの性能を改善したいのかを明確にします。
目的が不明確なまま多くの条件を実験しても、有用な結論が得られるとは限りません。
2. 因子と応答変数を選択する
特性要因図、5 Whys、現場観察、過去の測定データなどを参考にして、調べる因子を選びます。
応答変数についても、何を測定し、どのような結果を改善とみなすかを決めます。
必要であれば、強度、不良率、加工時間など複数の応答を測定します。
3. 水準と実験範囲を設定する
各因子について、どの値や条件を試すかを決めます。
広い範囲を試せば大きな変化を発見しやすくなる可能性がありますが、安全性や設備上の制約も考慮する必要があります。
狭すぎる範囲では、実際には重要な因子であっても、効果を発見できない場合があります。
4. 実験計画を選択する
比較実験、完全実施要因計画、一部実施要因計画、応答曲面計画などから、目的と制約に適した方法を選びます。
ランダム化、反復、ブロック化、必要な実験数なども検討します。
5. 実験を実施してデータを記録する
計画した条件で実験を行い、応答変数を測定します。
実際の実験では、計画した設定値だけでなく、実測値、実験日時、装置、材料ロット、異常の有無なども記録しておくことが重要です。
6. 統計解析を行う
主効果、交互作用、誤差、必要に応じて曲線的な関係などを推定します。
残差の分布やばらつき、実験単位の独立性など、統計モデルの前提についても確認します。
7. 解釈し、確認実験を行う
得られた結果を技術的な知識と照らし合わせ、どのような仕組みで効果が生じたのかを考えます。
必要であれば追加の実験を行い、別の条件やロットでも同様の結果が得られるかを確認します。
このように、実験計画法は一度の実験で結論を出す方法とは限りません。最初の実験で重要な要因を絞り込み、次の実験で関係を詳しく調べ、さらに確認実験を行うという段階的な進め方が合理的な場合もあります。
実験計画法の限界と注意点
選択しなかった要因は分析できない
実験計画法によって評価できるのは、原則として実験計画に組み込んだ因子や、適切に記録・考慮した条件です。
重要な原因を最初から見落としていれば、その影響を明らかにできない場合があります。
したがって、実験計画の前に現場観察や原因候補の洗い出しを行うことには重要な意味があります。
因子と水準の設定によって結論が変わる
ある因子が実験で重要ではないと判断されても、別の範囲では大きな影響を持つ可能性があります。
例えば、温度160~180℃では強度があまり変わらなくても、200℃付近で急激に劣化が始まるかもしれません。
実験結果は、調べた条件の範囲内で解釈する必要があります。
実験数を減らすと推定できる情報も制限される
一部実施要因計画や直交表を使えば、比較的少ない実験で多くの因子を調べられる場合があります。
しかし、交互作用が交絡するなど、情報の一部を失う可能性があります。
実験数を最小化することだけを目的にすると、必要な関係を識別できなくなるおそれがあります。
反復数が不足すると誤差を評価できない
実験条件の組合せが適切でも、測定値のばらつきに対する情報が不足していれば、結果の不確実性を十分に評価できません。
必要な反復数は、検出したい効果の大きさ、測定値のばらつき、求める検出力などを考慮して設計します。
統計モデルは現象そのものではない
実験結果に回帰式や応答曲面を当てはめることはできますが、数式が現実の物理的な仕組みを完全に説明しているとは限りません。
例えば、温度と時間に交互作用があることがわかっても、その理由が化学反応なのか、材料の構造変化なのか、別の現象なのかを理解するには、さらに専門的な調査が必要です。
統計モデルによって得られた関係と、その背後にある科学的なメカニズムは区別する必要があります。
実験できない問題もある
安全性、倫理、費用、時間などの制約によって、条件を自由に変更できない場合があります。
例えば、重大な事故につながる条件を試すことはできません。また、人間を対象とする研究では、倫理上の制約や同意取得などが必要になります。
このような場合には、既存データの解析、シミュレーション、観察研究など、別の方法を検討する必要があります。
AI時代の実験計画法 ― 実験の設計から次の仮説形成まで
実験計画法には、LLMによる支援や機械学習を導入できる部分が数多くあります。
しかし、AIに「実験計画を作成してください」と依頼するだけでは、適切な実験が設計されるとは限りません。問題の内容や実験上の制約を十分に理解しないまま、形式的に整った計画が作られる可能性があります。
AIを有効に活用するには、問題の理解、実験計画、統計解析、結果の解釈を区別することが重要です。
実験目的と因子の整理
LLMは、研究報告書、製品仕様書、故障記録、特性要因図などから、実験で調べるべき因子や応答変数の候補を抽出できます。
例えば、不良率を改善したいという目的に対して、材料、温度、加工時間、設備条件などの候補を整理し、必要な情報が不足していないかを指摘することが考えられます。
ただし、AIが候補として挙げた因子が実際に重要かどうかは、専門知識や現場の情報によって判断する必要があります。
実験計画の作成
因子の数、水準、利用可能な実験回数、制約条件などを入力し、目的に適した計画の候補を提示することができます。
完全実施要因計画、一部実施要因計画、直交表、応答曲面計画などを比較し、それぞれで推定できる効果や交絡関係を説明することも考えられます。
この部分は、LLMに数表を直接生成させるよりも、検証済みの統計計算プログラムを利用して設計行列を生成する方が確実です。
LLMは、利用者の目的を解釈し、適切な計算法を選択するためのインターフェースとして役立つでしょう。
解析結果の説明
実験後には、統計解析によって得られた主効果、交互作用、回帰モデル、信頼区間などを、LLMが自然言語で説明することができます。
例えば、「温度の効果は加工時間によって変化しているため、温度だけで最適条件を決めることはできない」といった説明です。
ただし、LLMが統計的な有意性や因果関係を誤って解釈する可能性もあるため、計算結果と説明内容を照合できる仕組みが必要です。
逐次的な実験計画
最初の実験結果から重要な因子を推定し、その結果に応じて次の実験条件を決めることができます。
例えば、最初に多数の因子を対象としたスクリーニング実験を行い、影響の大きそうな因子を選択します。
次に、その因子について応答曲面法を用いて最適条件を探索します。
さらに、得られた条件で確認実験を行います。
このような逐次的な実験計画は、従来の統計学でも発展してきた考え方です。近年では、ガウス過程などの予測モデルを利用し、次に実験する条件を選ぶベイズ最適化や能動学習も関連する方法として利用されています。
ただし、これらは古典的な要因実験と同一の手法ではなく、それぞれ異なるモデルの仮定や適用条件を持っています。
実験結果から新しい問題を発見する
実験は、最初に設定した仮説を検証するだけでなく、予想外の現象を発見する機会にもなります。
例えば、特定の材料と加工条件を組み合わせたときだけ、通常とは異なる性能が現れることがあります。
この結果は、最初の実験目的から見れば交互作用として分析されるかもしれません。しかし、その仕組みを詳しく調べれば、新しい技術的な可能性につながる場合もあります。
AIを利用して実験結果、過去の研究、類似する現象を関連づければ、次に調べるべき科学的な問題や、新しい応用仮説を考えるための支援が期待できます。
ThinkNaviでの位置づけ
ThinkNaviでは、実験計画法を「仮説の検証」と「問題解決」のための標準的な分析手法として位置づけます。
特性要因図や5 Whysによって原因候補を整理した後、それらの要因が実際に結果へ影響しているかを調べる方法として、実験計画法を利用できます。
ThinkNavi Freeの機能としては、因子と水準の設定、基本的な要因計画の作成、ランダム化された実験順序の生成、実験結果の入力、主効果と交互作用の可視化などが考えられます。
さらに、反復を含む実験に対応した分散分析や回帰分析などを組み込めば、実験の計画から結果の評価まで一貫して扱うことができます。ただし、推定できない効果や不足している反復、交絡関係などについては、明示的に利用者へ知らせる必要があります。
LLM活用版では、自然言語による実験目的の整理、因子候補の抽出、実験計画の選択支援、結果の解釈、追加実験の提案などが考えられます。これらは将来の機能構想であり、現在提供されている機能を示すものではありません。
ThinkNaviが実験計画法を扱う意義は、統計解析ソフトウェアのすべての機能を再現することだけではありません。
問題について原因の仮説を立て、検証するための実験を考え、結果を分析し、必要に応じて仮説を修正するという、一連の思考と調査を支援することにあります。
実験計画法の本質は、限られた実験からできるだけ多くの知識を得るために、何を、どの条件で、どのように比較するかを計画することです。適切に利用すれば、単なる試行錯誤を、検証可能な知識を積み重ねる活動へと変えることができます。
関連ページ
- 特性要因図(フィッシュボーン図)― 問題に影響する要因を体系的に整理する
- 5 Whys(なぜなぜ分析)|「なぜ」を繰り返して問題の原因を探る
- アブダクション|もっともらしい説明を考える
- 科学的方法|仮説・検証・発見
- システム思考|相互依存と時間変化を考える
- 多変量解析 ― 多くの変数から関係や構造を発見する統計的分析
- 回帰分析
- 分散分析(ANOVA)
- ベイジアンネットワーク|条件付き確率から推論する
- 意思決定マトリクス
参考文献・関連資料
- R. A. Fisher, The Design of Experiments, Oliver and Boyd, 1935.
- Douglas C. Montgomery, Design and Analysis of Experiments, Wiley.
- George E. P. Box, J. Stuart Hunter, and William G. Hunter, Statistics for Experimenters: Design, Innovation, and Discovery, Wiley, 2005.
- 田口玄一『実験計画法』丸善。
- NIST/SEMATECH — e-Handbook of Statistical Methods
- NIST — Choosing an Experimental Design
- Pennsylvania State University — STAT 503: Design of Experiments
- Pennsylvania State University — Introduction to Factorial Designs
- Pennsylvania State University — Response Surface Methods and Designs
- Pennsylvania State University — Experimental Units, Replication and Pseudoreplication