多変量解析(Multivariate Analysis)は、複数の変数を同時に扱い、それらの関係から予測、分類、情報の集約、隠れた構造の発見などを行う統計的な分析手法の総称です。製品の品質に影響する要因を調べる、顧客の購買行動を予測する、多数の測定項目から製品の特徴を把握する、アンケート回答の背後にある意識や価値観を探るなど、幅広い用途があります。
統計学の教科書では、確率分布、行列、固有値などの数学的な説明から多変量解析が紹介されることがあります。しかし、これから分析を利用しようとする人にとって、最初に知りたいのは「何を明らかにできるのか」「どのようなデータを用意すればよいのか」「分析すると何が出てくるのか」ということでしょう。
現在では、複雑な計算の多くを統計解析ソフトウェアに任せることができます。利用者にとって重要なのは、目的に適した手法を選び、得られた結果の意味と限界を理解することです。このページでは、代表的な四つの方法である重回帰分析、判別分析、主成分分析、因子分析を中心に、多変量解析の全体像を説明します。
統計学の全体像から多変量解析を理解する
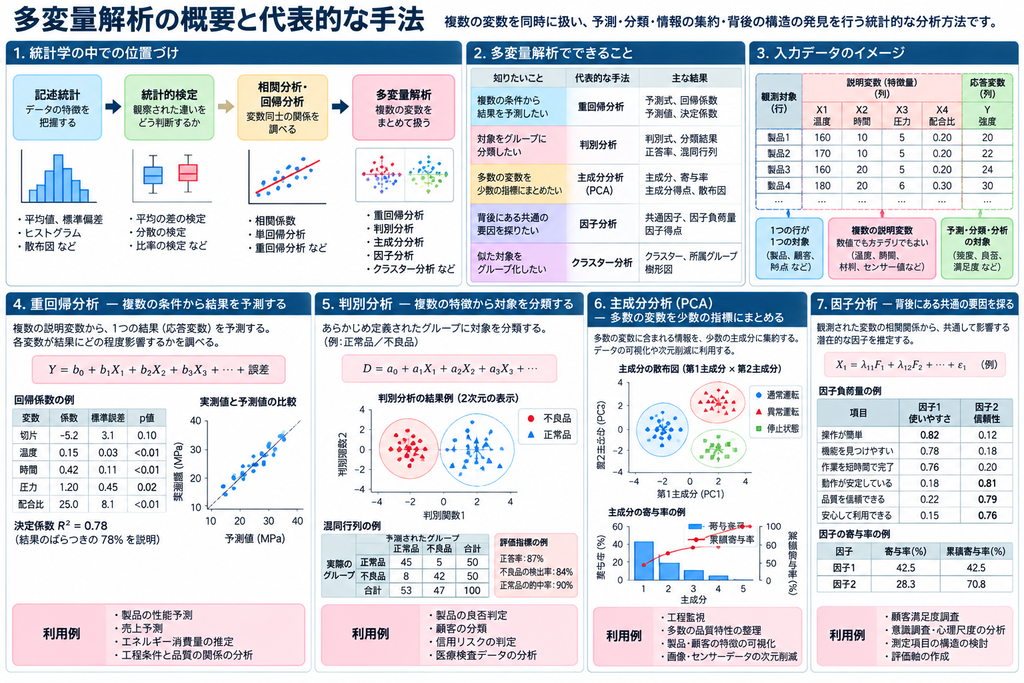
統計学を初めて学ぶ人には、次のように段階を追って理解することができます。
記述統計 ― データがどのような状態にあるかを把握する
例えば、100個の製品について強度を測定した場合、平均値、標準偏差、最大値、最小値などを計算します。ヒストグラムを描けば、測定値がどのように分布しているかがわかります。
記述統計は、集めたデータの特徴を整理するための基本的な方法です。
統計的検定 ― 観察された違いをどう判断するか
例えば、二つの製造方法で製品の平均強度が異なっていたとします。しかし、測定値にはばらつきがあるため、平均値の違いが偶然の変動によって生じた可能性も考えなければなりません。
統計的検定は、仮定した統計モデルのもとで、観察された違いがどのように評価されるかを調べるために使われます。検定だけで因果関係や実務的な重要性が決まるわけではありません。
相関分析・回帰分析 ― 変数同士の関係を調べる
例えば、加工温度が高くなると製品強度も高くなる傾向があるでしょうか。
二つの変数について散布図を描けば、関係の様子を視覚的に確認できます。相関係数を使えば、線形関係の方向や強さを数値で表せます。
回帰分析では、変数間の関係を数式で表し、ある変数の値から別の変数の値を推定します。
多変量解析 ― 複数の変数をまとめて扱う
現実の問題では、結果に影響する条件が一つとは限りません。
製品の強度には、温度だけでなく、加工時間、圧力、材料の成分、設備の状態などが関係するかもしれません。
また、目的が数値の予測とは限りません。製品を正常品と不良品に分類したい場合もあれば、数十種類の測定値から製品の特徴を少数の指標にまとめたい場合もあります。
多変量解析は、このような複数の変数を扱う問題に対応するための手法群です。
以上は理解のための順序であり、統計学の厳密な階層構造を表したものではありません。多変量解析にも記述的な方法と統計的推測を行う方法があり、検定や回帰分析と重なっています。また、厳密な統計学では、複数の説明変数を扱う multivariable と、複数の応答変数を同時に扱う multivariate を区別することがありますが、日本語では重回帰分析なども含めて「多変量解析」と呼ぶことが一般的です。
多変量解析で何ができるのか
多変量解析には非常に多くの手法がありますが、最初は分析の目的によって整理するとわかりやすくなります。
| 知りたいこと | 代表的な手法 | 得られる結果 |
|---|---|---|
| 複数の条件から結果を予測したい | 重回帰分析 | 予測式、各変数の係数、予測値 |
| 対象がどのグループに属するか判定したい | 判別分析 | 判別式、分類結果、正答率など |
| 多数の測定項目を少数の指標にまとめたい | 主成分分析 | 主成分、寄与率、主成分得点、散布図 |
| 観測項目の背後にある共通の概念を探りたい | 因子分析 | 共通因子、因子負荷量、因子得点 |
| 似た特徴を持つ対象をグループ化したい | クラスター分析 | クラスター、所属グループ、樹形図 |
ここでは、特に代表的な最初の四つを詳しく見ていきます。
1. 重回帰分析 ― 複数の条件から結果を予測する
重回帰分析(Multiple Regression Analysis)は、一つの結果に対して複数の変数がどのように関係するかを調べる方法です。
例えば、ある製品の強度が、加工温度、加工時間、材料の配合比率によって変化すると考えます。
実験や製造記録から、それぞれの条件と製品強度のデータを集めると、重回帰分析によって関係を数式で表すことができます。
最も基本的な重回帰モデルは、次のような形です。
Y = b₀ + b₁X₁ + b₂X₂ + b₃X₃ + … + 誤差
ここでYは予測したい結果、X₁、X₂、X₃は説明に使用する変数です。b₀は定数、b₁、b₂、b₃は各変数に対応する係数です。
例えば、Yを製品強度、X₁を温度、X₂を加工時間、X₃を材料の配合比率として分析できます。
この式は、複数の条件を組み合わせて結果を推定するモデルです。係数は、モデル内の他の説明変数を一定としたときに、ある変数が変化すると予測値がどのように変化するかを表します。
分析ソフトウェアから得られる結果
重回帰分析を実行すると、一般的に次のような結果が得られます。
- 回帰式:複数の説明変数から結果を予測する数式
- 回帰係数:各説明変数と結果の関係の方向や大きさ
- 決定係数(R²):モデルがデータ中の結果のばらつきをどの程度説明しているかを表す指標
- 係数の検定・信頼区間:各係数についての統計的不確実性
- 予測値と残差:モデルの予測と実測値の差
例えば、決定係数が0.78であれば、分析に使用したデータの結果のばらつきの78%がモデルによって説明されるという意味になります。ただし、これは説明用の数値であり、モデルが未知のデータを78%の正確さで予測するという意味ではありません。
実務では、回帰係数の一覧だけでなく、予測値と実測値を比較した散布図や、残差の分布などを見ることが重要です。
何に利用できるか
重回帰分析は、製品の性能予測、売上予測、エネルギー消費量の推定、工程条件と品質の関係の分析などに利用できます。
ただし、重回帰分析によって変数同士に関係があることがわかっても、それだけで原因と結果の関係が証明されるわけではありません。因果関係を調べるには、実験計画や、他の条件を考慮した分析が必要になる場合があります。
また、説明変数同士が強く相関していると、各変数の係数が不安定になることがあります。これは多重共線性と呼ばれる問題です。
2. 判別分析 ― 複数の特徴から対象を分類する
判別分析(Discriminant Analysis)は、特徴がわかっている対象を、あらかじめ定義されたグループのどれかに分類する方法です。
例えば、製品の寸法、重量、表面の状態、センサーの測定値などから、その製品が正常品か不良品かを判定したい場合に利用できます。
重回帰分析では数値を予測しますが、判別分析ではグループへの所属を予測します。
具体例 ― 製品の良否判定
過去の製造記録から、正常品と不良品について複数の測定値が得られているとします。
これらのデータを使って、正常品と不良品を区別するための数式を作成します。
線形判別分析の場合、判別得点を次のような式で表すことができます。
D = a₀ + a₁X₁ + a₂X₂ + a₃X₃ + …
Dは判別得点、X₁、X₂、X₃は測定値です。a₀、a₁、a₂、a₃は、グループを区別するために推定された係数です。
二群を扱う基本的な線形判別分析では、このような得点と判定規則を利用して新しい製品を分類できます。具体的な判定規則には、各グループの分布や事前確率などが関係します。
分析ソフトウェアから得られる結果
判別分析では、一般的に次のような結果が得られます。
- 判別式:グループを区別するための数式
- 判別得点:各対象について計算された値
- 分類結果:各対象がどのグループに判定されたか
- 混同行列:実際のグループと予測されたグループの対応表
- 分類精度:正しく判定できた割合や、特定のグループを検出できた割合
例えば、正常品と不良品の判別で全体の正答率が90%だったとしても、不良品の見逃しが多ければ、品質管理には適さない可能性があります。
したがって、単純な正答率だけでなく、不良品をどれだけ正しく検出できたか、正常品を誤って不良品と判断した割合はどの程度か、といった指標も確認します。
さらに、モデル作成に使用したデータだけで評価すると、性能を過大評価する場合があります。実用性を判断するには、学習に使っていないデータによる評価が重要です。
何に利用できるか
判別分析は、製品の良否判定、顧客の分類、信用リスクの判定、医療検査データの分析などに利用されます。
ただし、線形判別分析には、グループ内の変数の分布や共分散構造について一定の仮定があります。対象の性質に応じて、ロジスティック回帰、決定木、その他の分類モデルが適している場合もあります。
3. 主成分分析 ― 多数の変数を少数の指標にまとめる
主成分分析(Principal Component Analysis:PCA)は、多数の変数に含まれる情報を、できるだけ少数の新しい変数に集約する方法です。
例えば、ある製造装置について20種類のセンサーで温度、圧力、流量、振動、電流などを測定しているとします。
20種類の測定値を個別に眺めていても、設備の状態を把握することは簡単ではありません。複数のセンサーが似たような変化を示している場合もあります。
主成分分析では、元の変数を組み合わせて新しい指標を作成します。
例えば、最初の主成分は次のような式で表されます。
PC₁ = a₁X₁ + a₂X₂ + a₃X₃ + …
PC₁は第1主成分、X₁、X₂、X₃は元の変数です。係数は、データのばらつきをできるだけ多く表現するように決められます。
次に、第1主成分では表現されなかったばらつきをできるだけ多く表現する、第2主成分を求めます。以下、必要に応じて第3主成分、第4主成分を求めていきます。
元の20変数が持つ情報の多くを2~3個の主成分で表現できれば、多数の測定値を少数の指標によって扱いやすくなります。
ただし、少数の主成分に集約できる程度はデータによって異なります。また、主成分分析が保持しようとするのは主にデータのばらつきであり、分析目的にとって重要な情報が必ず残るとは限りません。
分析ソフトウェアから得られる結果
主成分分析では、一般的に次のような結果が得られます。
- 主成分:元の変数を組み合わせて作られた新しい指標
- 主成分負荷量など:各変数が主成分にどのように関係するかを示す値
- 寄与率:各主成分が元のデータのばらつきのどの程度を表現しているか
- 累積寄与率:複数の主成分でどの程度のばらつきを表現できるか
- 主成分得点:各対象について計算された主成分の値
- 主成分散布図:第1主成分と第2主成分などを軸に、対象を配置した図
例えば、20種類の測定変数を分析した結果、第1主成分と第2主成分で全体のばらつきの65%を表現できたとします。これは説明用の仮想例です。
この場合、各製品や各時点の測定結果を、二つの主成分を軸とする散布図上に配置できます。
正常な運転状態のデータが一つの領域に集まり、異常時のデータが別の領域に配置されれば、運転状態の違いを把握する手がかりになります。
ただし、主成分分析それ自体は、正常・異常というラベルを使って分離を最適化する方法ではありません。分類の精度が保証されるわけではありません。
何に利用できるか
主成分分析は、工程監視、多数の品質特性の整理、顧客や製品の特徴の可視化、画像・センサーデータの次元削減などに利用されます。
特に、多数の変数が相互に相関している場合、重複する情報を少数の軸に集約できる可能性があります。
一方、測定単位や変数のばらつきの大きさが異なる場合、標準化するかどうかによって結果が変わることがあります。どの変数を使い、どのように前処理するかが重要です。
4. 因子分析 ― 観測されたデータの背後にある共通の要因を探る
因子分析(Factor Analysis)は、複数の観測変数に共通して影響していると考えられる、直接は測定できない要因を探る方法です。
例えば、顧客満足度を調べるために、次のような質問を含むアンケートを実施したとします。
- 操作方法がわかりやすい
- 目的の機能をすぐに見つけられる
- 必要な作業を短時間で終えられる
- 製品の動作が安定している
- 製品の品質を信頼できる
- 安心して利用できる
これらの回答には、共通する傾向が現れる可能性があります。
最初の三つの質問には「使いやすさ」という共通の要因が、後の三つには「信頼性」という共通の要因が関係しているのではないか、と考えることができます。
因子分析は、観測された回答間の相関関係をもとに、こうした共通因子の構造を推定する方法です。
因子分析のモデル
因子分析では、観測された変数が、いくつかの共通因子と、その変数に固有の部分から構成されると考えます。
例えば、観測変数X₁を次のように表します。
X₁ = λ₁₁F₁ + λ₁₂F₂ + ε₁
F₁とF₂は共通因子、λは因子負荷量、ε₁は共通因子では説明されない固有の部分です。厳密なモデルでは平均や誤差などの条件も考慮します。
重回帰分析と似た形をしていますが、目的は異なります。
重回帰分析では、観測された説明変数から特定の結果を予測します。因子分析では、複数の観測変数に共通する変動を、少数の潜在的な因子によって説明しようとします。
分析ソフトウェアから得られる結果
因子分析では、一般的に次のような結果が得られます。
- 共通因子:観測変数に共通していると推定された要因
- 因子負荷量:各質問項目と共通因子の関係の強さを示す値
- 因子数の検討結果:いくつの因子でデータを説明するかを判断するための情報
- 共通性:各変数のばらつきのうち、共通因子によって説明される部分
- 因子得点:各対象について推定された因子の値
- 因子負荷量の図表:各変数がどの因子と関係するかを示す図
例えば、6個の質問項目から、使いやすさと信頼性に対応すると解釈できる二つの因子が抽出されるかもしれません。
ただし、統計解析ソフトウェアが「使いやすさ」「信頼性」という名称を客観的に発見するわけではありません。
因子負荷量や質問内容を確認しながら、分析者が因子の意味を解釈します。
また、回答項目の相関構造を説明する因子が得られても、その因子が独立した心理的実体として存在することが証明されたわけではありません。
何に利用できるか
因子分析は、心理学、社会調査、マーケティング、顧客満足度調査、組織調査などで幅広く利用されています。
多数の質問項目から少数の評価軸を見つけたい場合や、測定しようとしている概念の構造を検討する場合に役立ちます。
ただし、得られた因子構造の妥当性を判断するには、質問内容、調査対象、サンプル数、測定の信頼性などを検討する必要があります。
主成分分析と因子分析は何が違うのか
この二つは混同されやすい手法です。どちらも多数の観測変数から少数の指標を求めるため、結果が似て見えることがあります。
しかし、目的と基本的な考え方には違いがあります。
| 比較項目 | 主成分分析 | 因子分析 |
|---|---|---|
| 主な目的 | 情報を少数の指標に集約する | 観測変数に共通する潜在因子を推定する |
| 基本的な考え方 | 観測変数の線形結合から新しい軸を作る | 共通因子が観測変数の関係を説明すると仮定する |
| 主な結果 | 主成分、寄与率、主成分得点 | 因子負荷量、共通性、因子得点 |
| 典型的な用途 | 次元削減、データの可視化 | 心理尺度、意識調査、潜在構造の探索 |
例えば、20種類のセンサー情報を二つの指標にまとめて設備状態を把握したいなら、主成分分析が候補になります。
一方、20個のアンケート項目の背後に、どのような共通の心理的構成概念があるかを調べたいなら、因子分析が候補になります。
もちろん、分析目的やデータによって適切な選択は異なります。
その他の代表的な多変量解析手法
多変量解析は、これまで紹介した四つだけではありません。
例えば、クラスター分析は、あらかじめグループを指定せず、似た特徴を持つ対象を分類するために使われます。既知のグループを判別する判別分析とは目的が異なります。
多次元尺度構成法(MDS)は、対象間の類似性や距離をもとに、二次元や三次元の空間へ配置する方法です。製品イメージやブランドの位置づけを把握する場合などに利用できます。
対応分析は、カテゴリー間の関係を可視化するために利用されます。例えば、顧客属性と商品カテゴリーのクロス集計表から、関係の特徴を調べることができます。
PLS回帰は、多数の説明変数が強く相関している場合などに利用される回帰手法です。変数の情報を少数の成分に集約しながら、目的変数との関係をモデル化します。
また、多変量分散分析(MANOVA)は、複数の応答変数をまとめて比較する方法です。
これらの手法をすべて覚える必要はありません。まずは自分が何を知りたいのかを明確にし、その目的に適した手法を選択することが重要です。
分析ソフトウェアを使うときに重要なこと
多変量解析の数式をすべて理解していなくても、ソフトウェアを使って実際のデータを分析することは可能です。しかし、手法の名称を知り、ボタンを押せば正しい結果が得られるわけではありません。
第一に、分析目的とデータの構造を確認します。 何を予測したいのか、何を分類したいのか、どのような関係を発見したいのかを明確にします。また、行が何を表し、列が何を表しているのか、測定単位や欠損値の扱いは適切かを確認します。
第二に、変数の選択と前処理を検討します。 不要な変数を大量に追加すると、分析が複雑になるだけでなく、結果の信頼性が低下する場合があります。標準化、欠損値処理、異常値の確認なども重要です。
第三に、モデルの仮定と限界を確認します。 例えば、重回帰分析には残差や説明変数の関係について考慮すべき条件があり、判別分析にも使用するモデルに応じた仮定があります。主成分分析や因子分析では、変数間の関係や前処理、抽出した成分・因子の解釈が重要になります。
第四に、分析結果の再現性や予測性能を確認します。 多くの変数を使うと、分析に使用したデータにはよく適合していても、別のデータには適合しないことがあります。予測や分類では、学習に使用していないデータで性能を評価することが重要です。
第五に、統計的な関係と因果関係を区別します。 多変量解析によって有意な関係や明確なグループ構造が得られても、その結果だけで原因が証明されるわけではありません。必要に応じて、実験計画法、追加調査、専門知識による検証を組み合わせます。
多変量解析と機械学習の関係
多変量解析と機械学習は、まったく別の領域ではありません。
重回帰分析や判別分析は、統計学の手法であると同時に、機械学習における予測・分類モデルとしても利用できます。主成分分析やクラスター分析は、教師なし学習の代表的な方法として扱われることもあります。
一方、機械学習には、決定木、ランダムフォレスト、勾配ブースティング、ニューラルネットワークなど、多様な方法があります。
従来の統計学では、係数の推定、仮説検定、モデルの解釈などが重視されることが多く、機械学習では未知のデータに対する予測性能が特に重視されることがあります。しかし、これは一般的な傾向であり、統計学でも予測は重要ですし、機械学習でも解釈や因果関係の研究が行われています。
どちらの名前で呼ばれるかよりも、分析によって何を明らかにしたいのかが重要です。
定性的な分析と多変量解析の接続
多変量解析は数値データを扱いますが、分析の出発点や結果の利用には、定性的な思考が深く関係しています。
例えば、顧客満足度調査では、最初に顧客へのインタビューを行い、どのような問題や関心があるかを調べることができます。
その結果をKJ法などで整理し、重要と思われる観点を抽出します。次に、それらの観点を測定するための質問項目を作成し、アンケート調査を実施します。
集めた回答を因子分析すれば、質問項目の背後にある共通因子を検討できます。
さらに、抽出した因子と顧客満足度や継続利用意向との関係を重回帰分析などで調べることも考えられます。
つまり、次のような連続した分析が可能です。
インタビュー → KJ法による情報整理 → 仮説・質問項目の作成 → アンケート調査 → 因子分析 → 重回帰分析 → 結果の解釈と新しい仮説
このような流れでは、定性分析と定量分析を独立した作業として切り離す必要はありません。
ただし、定性的な観察から作成した質問項目が、意図した概念を適切に測定しているかどうかは検証が必要です。多変量解析を適用したからといって、元の概念の定義や測定方法が正しいことまで保証されるわけではありません。
AI時代の多変量解析
近年のLLMは、統計解析ソフトウェアの利用方法や、分析結果の理解を支援するためにも活用できます。
例えば、利用者が「製品の強度にどの条件が影響しているかを調べたい」と入力すれば、AIが重回帰分析や実験計画法などの候補を提示し、必要なデータについて説明することが考えられます。
また、「顧客アンケートの20項目を少数の評価軸に整理したい」と入力すれば、主成分分析と因子分析の違いを説明し、目的に合った手法を選ぶ支援ができます。
分析を実行した後には、係数、寄与率、因子負荷量、分類精度などの結果を自然言語で説明することも可能です。
ただし、LLMに計算結果を推測させるべきではありません。統計計算は検証済みの数値計算プログラムで行い、LLMは分析目的の整理、手法の選択、結果の説明、問題点の指摘などを支援する構成が適切です。
特に注意すべきなのは、AIがもっともらしい解釈を生成できることです。主成分に意味のありそうな名称を付けたり、相関関係に因果的な説明を与えたりすることは容易ですが、それが実際に正しいとは限りません。
AIの説明についても、元の変数、計算結果、使用したモデル、データの範囲などを確認できることが重要です。
ThinkNaviでの位置づけ
ThinkNaviでは、多変量解析を独立した専門領域として隔離するのではなく、問題発見、原因分析、仮説検証、予測、分類、意思決定などの目的に応じて利用できる分析技法として位置づけます。
例えば、特性要因図によって原因候補を整理した後に、重回帰分析で複数の変数と結果の関係を調べることができます。顧客調査では、KJ法などによる情報整理から因子分析へ進むことができます。多数の技術特性を持つ製品群を比較する場合には、主成分分析によって特徴を可視化し、その結果を意思決定の材料にすることも考えられます。
ThinkNavi Freeでは、主要な多変量解析手法について、データの入力、分析の実行、結果の可視化、基本的な統計指標の表示などを行うツール群を段階的に整備することが考えられます。
LLM活用版では、利用者が分析したい問題を自然言語で説明し、適切な手法の選択、データの確認、分析条件の設定、結果の理解、追加調査の検討までを支援することが考えられます。これらは将来の機能構想であり、現在提供されている機能を示すものではありません。
多変量解析を利用するために、すべての手法の数理的な導出を理解する必要はありません。しかし、どのような目的に使う手法なのか、何を入力し、どのような結果が得られるのか、その結果から何を判断でき、何を判断できないのかを理解する必要があります。
多変量解析の価値は、複雑な数学を使うこと自体ではなく、一つの変数だけを見ていてはわからなかった関係や構造を、多数のデータから発見することにあります。
関連ページ
- 統計学とは ― データから規則性を発見し、不確実な世界を理解する
- 記述統計
- 相関分析
- 回帰分析・重回帰分析
- 判別分析
- 主成分分析
- 因子分析
- クラスター分析
- 実験計画法(DOE)実験計画法(DOE)― 複数の要因とその交互作用を調べるための実験設計
- 特性要因図特性要因図(フィッシュボーン図)― 問題に影響する要因を体系的に整理する
- KJ法|断片的な情報から意味のある全体像を組み立てる
- アブダクション|もっともらしい説明を考える
- 意思決定マトリクス
参考文献・関連資料
- Richard A. Johnson and Dean W. Wichern, Applied Multivariate Statistical Analysis, 6th ed., Pearson, 2007.
- T. W. Anderson, An Introduction to Multivariate Statistical Analysis, 3rd ed., Wiley, 2003.
- J. E. Jackson, A User’s Guide to Principal Components, Wiley, 1991.
- Pennsylvania State University — STAT 505: Applied Multivariate Statistical Analysis
- Pennsylvania State University — Multiple Linear Regression
- Pennsylvania State University — Discriminant Analysis
- Pennsylvania State University — Principal Components Analysis
- UCLA Statistical Consulting — Principal Components Analysis: Annotated Output
- NIST/SEMATECH — e-Handbook of Statistical Methods