システムダイナミクス(System Dynamics:SD)は、システムを構成する要素の間に存在する因果関係、フィードバック、蓄積、時間の遅れなどを数理モデルとして表現し、システムが時間とともにどのように変化するかを分析する方法論です。
1950年代にジェイ・フォレスター(Jay W. Forrester)によって開発され、企業の生産・在庫・流通などの問題から、都市、経済、環境、医療、組織管理などの分野へ応用されてきました。
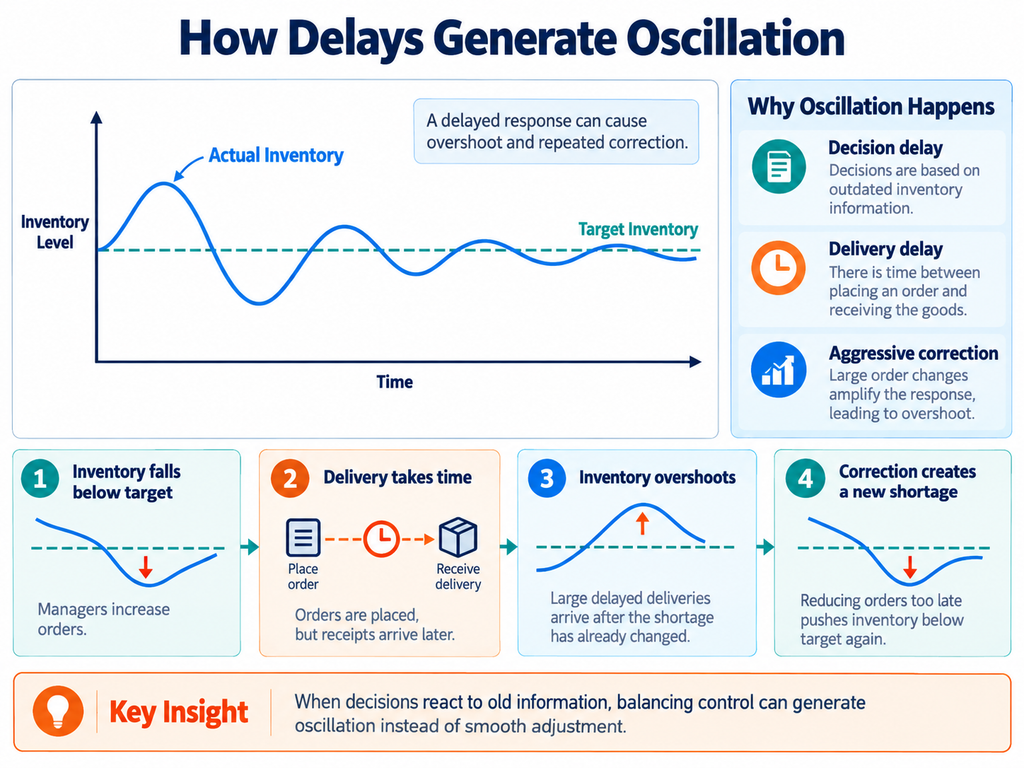
例えば、企業の在庫管理では、顧客からの需要、在庫量、発注量、納入までの時間などが相互に関係しています。在庫が不足すると発注量が増えますが、発注から納入までには時間がかかります。その間に追加発注が行われれば、後になって過剰在庫が発生する可能性があります。
このような問題を理解するには、単に「在庫不足が発生した原因」を調べるだけでは不十分な場合があります。発注の意思決定、納入の遅れ、在庫の蓄積などが、時間とともにどのような振る舞いを生み出すかを検討する必要があります。
システムダイナミクスでは、こうした構造をストック、フロー、変数、方程式などによって表現します。さらに、モデルをコンピュータ上で実行し、条件や施策を変更した場合の時間変化を比較します。
ただし、シミュレーション結果は、モデルに設定された因果関係やパラメータが適切であることを自動的に保証するものではありません。現実のシステムをどのようにモデル化したかによって、得られる結果は変わります。
システムダイナミクスの目的は、将来の数値を計算することだけではありません。システムの振る舞いがどのような構造から生まれるかを理解し、異なる介入策や意思決定によって何が変化するかを検討することです。
システムダイナミクスの歴史と発展
システムダイナミクスは、1950年代にMITのジェイ・フォレスターによって開発されました。当初は、企業における在庫、製造、流通、受注などの問題を、フィードバックを持つ動的システムとして分析することが主要な対象でした。
1961年の著書『Industrial Dynamics』は、この方法論を体系的に説明した代表的な文献です。
その後、フォレスターは都市問題を扱った『Urban Dynamics』(1969年)、世界規模の問題を扱った『World Dynamics』(1971年)を発表しました。
また、1972年の『The Limits to Growth』では、人口、資源、工業生産、食料、環境汚染などの相互作用を含む世界モデルが利用されました。
このように、システムダイナミクスは、コンピュータが現在よりもはるかに低性能だった時代から発展してきた方法論です。
そのため、現代のAIや機械学習と比較すると、古い技術という印象を持たれることがあります。
しかし、システムダイナミクスは、その後も研究と実装が継続されてきました。特に近年は、データ分析、統計的推定、AI、他のシミュレーション方式との連携などによって、新しい技術的な可能性が生まれています。
| 時期 | 主な発展 |
|---|---|
| 1950〜1960年代 | 企業活動のフィードバックと蓄積を数理モデル化 |
| 1970〜1980年代 | 都市、環境、経済、社会システムなどへ応用 |
| 1990〜2000年代 | GUIによるモデル作成、組織学習、政策評価への普及 |
| 2010年代 | オープンなモデル表現、Python連携、複数シミュレーション方式の統合が進展 |
| 2020年代 | AIによるモデル構築支援、ベイズ推定、ハイブリッド化、構造的なモデル分析などが進展 |
こうした発展を理解するには、システムダイナミクスの基本原理と、その周辺で進んでいる技術を区別することが重要です。
システムダイナミクスの基本原理
2024年に『System Dynamics Review』へ掲載されたAsmeret Naugle、Saeed Langarudi、Timothy Clancyによる論文「What Is (Quantitative) System Dynamics Modeling?」では、定量的システムダイナミクスの特徴として、次の五つが整理されています。
| 基本原理 | 内容 |
|---|---|
| 因果的なフィードバック構造 | システムの要素が相互に影響する構造に基づく |
| 蓄積と遅れ | ストックと時間の遅れを基本的な要素として扱う |
| 方程式による表現 | システムの関係を数理的に記述する |
| 連続時間の概念 | 時間とともに連続的に変化する状態を扱う |
| フィードバックによる振る舞いの分析 | システムの構造がどのような時間変化を生むかを調べる |
これらは、システムダイナミクスを他のシミュレーション方式と区別するための重要な特徴です。
例えば、ある工程を製品が一つずつ通過する様子を再現する場合には、離散事象シミュレーションが適していることがあります。
また、個々の作業者や顧客の行動をモデル化する場合には、エージェントベースモデルが適していることがあります。
システムダイナミクスは、比較的集約された変数を用いて、蓄積とフィードバックによる全体的な変化を扱うことに特徴があります。
ただし、異なる方法を組み合わせることも可能です。
ストックとフローによるモデル化
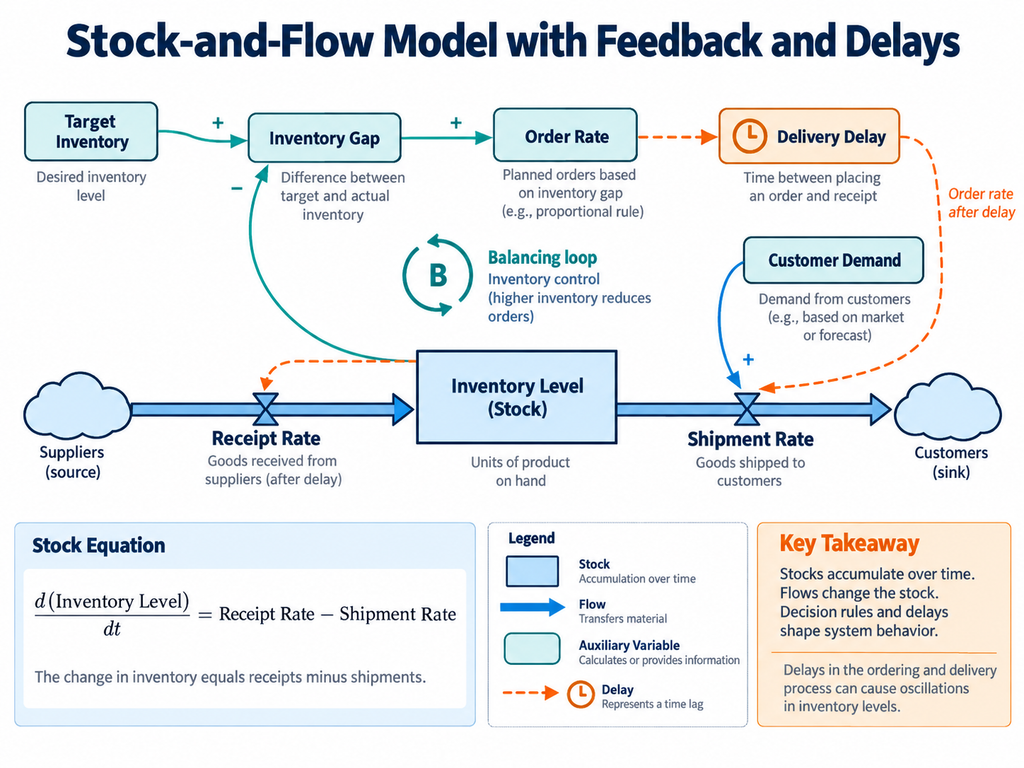
システムダイナミクスでは、ストック(Stock)とフロー(Flow)を区別します。
ストックは、時間とともに蓄積される量です。
フローは、その蓄積量を増減させる流入や流出の速度です。
例えば、倉庫の在庫量はストックであり、入荷率と出荷率はフローです。
在庫量を (S(t))、入荷率を (I(t))、出荷率を (O(t)) とすると、単純化したモデルは次のように表現できます。
[
\frac{dS(t)}{dt}=I(t)-O(t)
]
この式は、在庫量の変化率が、入荷率と出荷率の差によって決まることを表しています。
在庫量の単位が「個」であれば、入荷率と出荷率の単位は「個/日」などになります。
この式だけでは、入荷率と出荷率がどのように決まるかはわかりません。
そこで、発注ルール、需要、納入までの時間、供給能力などを追加します。
例えば、在庫不足によって発注率が増え、発注率の増加によって一定時間後に入荷率が増えるという関係です。
このような因果的な関係を組み合わせることで、モデルは単純な蓄積計算から、フィードバックを持つ動的モデルへ発展します。
なお、連続時間モデルをコンピュータ上で実行する際には、数値積分などによって計算します。
計算時間刻みが大きすぎる場合には、実際には存在しない振動や数値的不安定性が生じる可能性もあるため、計算方法と精度の確認が必要です。
因果ループ図とストック・フローモデル
システムダイナミクスでは、因果ループ図(Causal Loop Diagram:CLD)とストック・フロー図(Stock-and-Flow Diagram:SFD)が利用されます。
因果ループ図は、変数間の因果関係を矢印で結び、強化型・調整型のフィードバックを可視化する方法です。
一方、ストック・フロー図は、何が蓄積され、どのような流入・流出によって変化するかを明示します。
| 観点 | 因果ループ図 | ストック・フロー図 |
|---|---|---|
| 主な目的 | フィードバックの構造を理解する | 蓄積と時間変化をモデル化する |
| 主な構成要素 | 変数、因果リンク、ループ | ストック、フロー、補助変数、方程式 |
| 数値シミュレーション | 通常は図だけでは実行できない | 関係式とパラメータがあれば実行できる |
| 利用場面 | 問題の構造化、因果仮説の整理 | 動的な予測、施策比較、感度分析 |
因果ループ図は、モデル化する問題を理解するための重要な道具ですが、一般的な因果ループ図から、正しいストック・フローモデルが一意に決まるわけではありません。
例えば、「広告費が売上高へ正の影響を与える」という矢印があっても、その効果が比例関係なのか、飽和するのか、どれだけ遅れて現れるのかは不明です。
この関係を数理モデルへ変換するには、さらに具体的な定義が必要です。
そして、この因果ループ図と定量モデルの間の隔たりを埋めることも、近年の研究課題になっています。
技術的進展1 ― 観測データを利用したモデル推定
初期のシステムダイナミクスでは、専門家の知識や既存の統計資料を参考にして、モデル構造とパラメータを設定する方法が利用されてきました。
しかし、モデルに含まれるパラメータが適切でなければ、シミュレーションの結果は現実の振る舞いと一致しません。
例えば、採用活動を増やしたときに対応可能な従業員が増えるまでの期間や、問い合わせ件数と対応時間の関係などは、実際のデータに基づいて推定する必要があります。
現在は、統計的推定や最適化などを利用して、モデルのパラメータをデータから推定する方法を組み込みやすくなっています。
例えば、観測された在庫量の時系列と、モデルが再現した在庫量の時系列の差が小さくなるように、パラメータを調整することが考えられます。
ただし、観測データにモデルを適合させることと、モデルに含まれる因果構造が正しいことは別です。
異なるモデル構造でも、似た時系列を再現できる場合があります。
また、複数のパラメータの組み合わせが同じような結果を生む場合には、個々のパラメータを一意に推定することが難しくなります。
この問題は、パラメータの識別可能性(Identifiability)に関係します。
データによるパラメータ推定は、モデルを現実に近づけるための重要な進展ですが、それだけで因果構造の検証が完了するわけではありません。
技術的進展2 ― ベイズ推定による不確実性の扱い
従来のパラメータ推定では、最も適合する一組のパラメータを求めることが中心になる場合があります。
しかし、実際のモデルでは、観測データが不足していたり、複数のパラメータが似た影響を与えたりするため、一つの値へ確定できない場合があります。
ベイズ推定では、パラメータを単一の値として扱うだけでなく、確率分布として推定することができます。
これによって、推定値の不確実性を考慮した分析が可能になります。
例えば、ある企業の顧客解約率について、特定の値だけを仮定するのではなく、観測データから複数の可能な値とその不確実性を考慮することができます。
モデルのシミュレーションを繰り返すことで、将来の顧客数や売上高について、幅を持った予測を考えることもできます。
ただし、ベイズ推定による結果は、事前分布、観測モデル、モデル構造などの仮定に依存します。
また、ベイズ推定そのものは新しい技術ではありません。近年の進展は、こうした推定方法を複雑なシステムダイナミクスモデルへ適用しやすくなっていることにあります。
深層学習を利用した新しい推定方法
2025年には、Hazhir Rahmandad、Ali Akhavan、Mohammad S. Jalaliらによる論文「Incorporating Deep Learning Into System Dynamics: Amortized Bayesian Inference for Scalable Likelihood-Free Parameter Estimation」が『System Dynamics Review』に掲載されました。
この研究では、Amortized Bayesian Inference(ABI)をシステムダイナミクスへ適用しています。
ABIは、シミュレーションから生成したデータを利用してニューラルネットワークを学習させ、新しい観測データに対するパラメータの事後分布を効率的に推定しようとする方法です。
ここでは、システムダイナミクスモデルが生成する模擬データを利用して、推定に必要な機械学習モデルを構築しています。
研究では比較的単純な二つのシステムダイナミクスモデルを用いて、その実現可能性が検討されました。
これは、単にコンピュータの計算速度が向上したという話ではありません。
シミュレーションモデルと深層学習による統計的推論を組み合わせ、不確実性を含めてモデルを推定するという方法論上の進展です。
ただし、この研究だけで、任意の大規模システムダイナミクスモデルを高精度に推定できることが確立されたわけではありません。
技術的進展3 ― フィードバックの寄与を定量的に分析する
因果ループ図では、強化型と調整型のフィードバックを識別できます。
しかし、複数のループが存在する場合、どのループがシステムの振る舞いに大きく影響しているかを、図の形だけから判断することはできません。
そこで、フィードバック構造とシミュレーション結果の関係を定量的に分析する研究が行われてきました。
これらは、ループ支配性分析(Loop Dominance Analysis)などと呼ばれます。
例えば、ある企業の利用者数が急増した後に成長率が低下した場合を考えます。
モデルには、紹介による新規獲得を促す強化型ループと、サポート能力の不足によって解約を増やす調整型ループが含まれているとします。
単に二つのループが存在するだけでは、実際にどちらが成長率の変化を主導しているかはわかりません。
ループ支配性分析では、モデルの構造と計算結果を利用し、各ループが振る舞いに与える寄与を調べます。
2024年には、John HaywardとPaul A. Roachによる「A Comparison of Loop Dominance Methods: Measures and Meaning」が発表され、複数の分析方法とその解釈が比較されています。
この分野では、フィードバックの寄与をどのように定義し、利用者が理解できる形で説明するかが重要な課題になっています。
これは、システムダイナミクスが単にシミュレーション結果を出力するだけでなく、なぜその振る舞いが生じたのかを、モデル構造に基づいて分析する方向へ発展していることを示しています。
ただし、分析結果はモデル内部の関係に基づくため、現実世界で同じ因果構造が成立していることを自動的に証明するものではありません。
技術的進展4 ― 他のシミュレーション方式とのハイブリッド化
システムダイナミクスは、全体的な蓄積量やフィードバックを扱うことに適しています。
しかし、現実のシステムでは、個々の要素の違いや、特定の出来事の発生順序が重要になる場合があります。
例えば、工場の生産能力を分析する場合、全体の仕掛品量や生産率を扱うだけでは、個々の設備をどの製品がどの順番で通過するかを表現できないことがあります。
このような問題に対しては、異なるシミュレーション方式を組み合わせることが考えられます。
| 方法 | 主に扱うもの | 適した問題の例 |
|---|---|---|
| システムダイナミクス(SD) | 蓄積、フロー、フィードバック | 在庫、需要、投資、組織の長期的変化 |
| 離散事象シミュレーション(DES) | 個別のイベントと処理の進行 | 生産工程、待ち行列、設備稼働 |
| エージェントベースモデル(ABM) | 個々の主体の行動と相互作用 | 顧客行動、感染拡大、企業間競争 |
例えば、SaaS事業を考える場合、顧客数の増減や売上の蓄積をシステムダイナミクスで扱い、異なる属性を持つ顧客の選択行動をエージェントベースモデルで扱うことが考えられます。
また、生産工場では、需要や投資の長期的な変化をシステムダイナミクスで扱い、個々の製品の工程通過や待ち時間を離散事象シミュレーションで扱うことができます。
このようなハイブリッドシミュレーションは、複数の抽象度を持つモデルを組み合わせるための方法です。
2024年には、Le Khanh Ngan Nguyen、Susan Howick、Itamar Megiddoによる論文「A Framework for Conceptualising Hybrid System Dynamics and Agent-Based Simulation Models」が発表され、SDとABMを組み合わせるための概念モデル設計が整理されました。
2026年の研究レビューでも、SDとABMのハイブリッドモデルに関する研究が増加している一方、モデルの検証、再現性、解釈可能性には課題が残ることが指摘されています。
ハイブリッド化は重要な進展ですが、常に複数の方式を組み合わせた方がよいというわけではありません。
異なるモデルを結びつけるためには、変数の対応、時間の進め方、モデル間の情報交換などを適切に設計する必要があります。
技術的進展5 ― Pythonとデータサイエンスとの連携
従来のシステムダイナミクスは、専用のモデリングソフトウェアによって実装されることが多くありました。
現在もVensim、Stella、AnyLogicなどのツールが利用されていますが、Pythonなどのプログラミング環境からモデルを扱うための選択肢もあります。
代表例の一つが、オープンソースのPySDです。
PySDは、VensimやXMILE形式で記述されたシステムダイナミクスモデルをPython上で扱うためのライブラリです。
これによって、システムダイナミクスモデルと、Pythonのデータ分析や機械学習のライブラリを組み合わせることができます。
例えば、次のような作業が考えられます。
- 観測データを利用してモデルのパラメータを調整する
- パラメータを変更しながら多数のシミュレーションを実行する
- 統計的な分析によってシミュレーション結果を評価する
- 最適化アルゴリズムを用いて介入策を比較する
- 機械学習を利用して、関係式の一部を近似する
また、複数のモデルや分析機能を一つのアプリケーションに組み込むことも考えられます。
これは、システムダイナミクスを単独の専用ソフトウェア内で完結させるのではなく、より広いデータ分析・シミュレーション環境の一部として利用する方向です。
ただし、ライブラリによってサポートされる機能やモデル形式は異なります。
また、Python上で実行できることと、モデルが正しいことは別です。
技術的進展6 ― LLMによるモデル生成
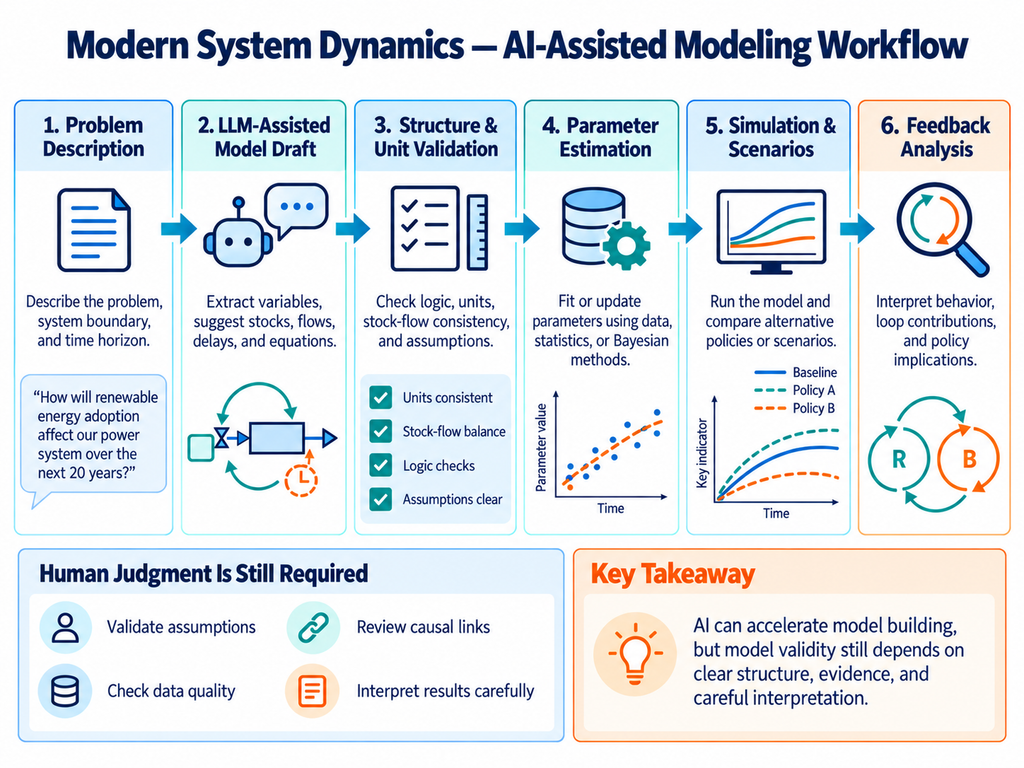
近年の進展の中でも、特に変化が大きいのが、LLMを利用したモデル構築の支援です。
従来、システムダイナミクスモデルを構築するには、変数の定義、因果関係の整理、ストック・フローの設計、方程式の作成などを、人間のモデラーが行う必要がありました。
この作業には専門的な知識が必要であり、システムダイナミクスを広く利用するうえでの障壁の一つでした。
しかし、LLMを利用することで、文章による問題の説明から、モデルの構成要素を抽出することが可能になってきました。
例えば、次のような説明から始められます。
「顧客からの問い合わせが増えており、未処理件数が増加している。担当者を増員すると対応能力が向上するが、採用と教育に時間がかかる」
LLMは、この文章から未処理件数、問い合わせ到着率、対応完了率、担当者数などの変数を候補として抽出できます。
さらに、因果関係やストック・フロー構造を提案することが考えられます。
2024年:文章から因果ループ図を生成する研究
2024年には、Niyousha Hosseinichimehらによる「From Text to Map: A System Dynamics Bot for Constructing Causal Loop Diagrams」が発表されました。
この研究では、LLMを利用して文章から因果ループ図を生成する仕組みが提案されています。
論文では、システムダイナミクスの文献に由来する20組の図と文章、および30人の参加者から得た回答などを使って評価しています。
その結果、対象データにおける変数間のリンクやフィードバックループの約60%を識別できたと報告されています。
これは自動化の可能性を示していますが、同時に、人間が作成した構造を完全には再現できていないことも示しています。
2026年:実行可能なモデルの生成
2026年には、William Schoenbergによる「Building and Learning With Models Using AI」が『System Dynamics Review』に掲載されました。
この研究では、オープンソースのsd-aiという枠組みが紹介されています。
そこには、自然言語をもとにストック・フローモデル、方程式、単位、ドキュメントなどを生成する機能と、シミュレーション結果について対話的に説明する機能が含まれています。
また、前述のフィードバック構造の分析を利用し、モデルの振る舞いについて根拠を持った説明を行う方向も示されています。
これは、単に「因果ループ図をLLMに描かせる」段階から、実行可能な数理モデルの構築と分析を支援する段階へ進んでいることを示す研究例です。
ただし、AIが生成したモデルは、人間による検証や修正を必要とします。
方程式が構文的に正しく実行できることと、モデルが現実のシステムを適切に説明していることは異なります。
技術的進展7 ― 因果ループ図から実行可能なモデルへの変換
因果ループ図は、システムの因果構造をわかりやすく表すことができます。
しかし、一般的な因果ループ図には、数理モデルを構築するために必要な情報が不足しています。
例えば、変数がストックなのかフローなのかが明示されていない場合があります。
また、単に「正の影響がある」というだけでは、具体的な関係式を決めることができません。
この問題に対して、2026年には「Graph Notation as a Gateway—Transitioning from Causal Loop to Stock and Flow Diagrams (and Beyond) in System Dynamics Modeling」という研究が発表されました。
この研究では、CLD+という拡張された因果ループ図の記法が提案されています。
CLD+では、従来の因果ループ図よりも多くの構造的な情報を明示します。
例えば、変数がストックなのかフローなのか、リンクが物質の流れなのか情報の影響なのか、どこに時間の遅れが存在するのか、といった区別です。
このような情報を十分に与えることで、ストック・フロー構造への変換を明確にできるという考え方です。
ただし、これは一般的な因果ループ図をそのまま自動変換できるという意味ではありません。
また、モデル構造が定義できたとしても、数値シミュレーションには適切な関係式とパラメータが必要です。
それでも、図による概念的な整理と、実行可能な数理モデルとの間をつなぐ技術として重要な方向です。
技術的進展8 ― デジタルツインとの関係
デジタルツイン(Digital Twin)は、実際の設備やシステムの状態をデジタルモデルと結びつけ、監視、分析、予測、最適化などに利用しようとする技術です。
デジタルツインは、システムダイナミクスと同じものではありません。
例えば、機械の温度、振動、摩耗などを高い時間分解能で扱う場合には、物理シミュレーションや状態推定が中心になることがあります。
一方、工場全体の設備投資、保守能力、人員、在庫などの長期的な変化を考える場合には、システムダイナミクスを利用できる可能性があります。
また、実際のデータによってモデルの状態やパラメータを更新することで、モデルと現実のシステムのずれを小さくする方法も考えられます。
ただし、システムダイナミクスモデルをセンサーデータと接続しただけで、信頼できるデジタルツインが完成するわけではありません。
モデルの状態やパラメータをどのように更新するか、測定できない状態をどう扱うか、どの程度の精度で予測できるかなどを検討する必要があります。
2026年のデジタルツイン関連研究でも、モデルと現実データの継続的な同期や、実環境での厳密な検証が依然として課題であることが指摘されています。
したがって、デジタルツインとの統合は、システムダイナミクスの応用を広げる一つの方向ですが、すべてのデジタルツインでシステムダイナミクスが必要になるわけではありません。
現在のシステムダイナミクスで何が変わったのか
ここまでの技術的な進展を、従来の方法と比較して整理します。
| 観点 | 従来の代表的な方法 | 現在の進展 |
|---|---|---|
| モデルの作成 | 専門家が変数と方程式を手作業で設計 | LLMによる構造・方程式の草案生成 |
| パラメータ推定 | 専門家の判断、最適化、既存の統計手法 | ベイズ推定、深層学習を利用した推定など |
| モデル分析 | シミュレーション結果の比較 | ループ支配性などの構造的な寄与分析 |
| シミュレーション方式 | SD単独のモデル | ABM・DESなどとのハイブリッド化 |
| 実装環境 | 専用ソフトウェア中心 | Python、オープンなモデル形式、外部ライブラリとの連携 |
| モデルとデータ | 事前のパラメータ設定や定期的な更新 | 動的な更新・データ同化との統合可能性 |
| 利用者との対話 | モデラーが結果を解釈して説明 | AIによる対話的なモデル構築・説明支援 |
ただし、これらの技術には成熟度の違いがあります。
Pythonを使ったモデル実行やハイブリッドシミュレーションは、すでに実装環境や利用事例があります。
一方、LLMによって複雑なモデルを自動生成し、十分な検証を行ったうえで業務へ投入する仕組みについては、まだ研究・発展の余地が大きいと考えられます。
また、最新の機能を利用すれば、モデルの妥当性が自動的に保証されるわけではありません。
システムダイナミクスが現在も有用な理由
システムダイナミクスは古くから存在する方法論ですが、その基本的な問題意識は現在でも重要です。
企業や社会の問題では、複数の要因が相互に影響し、その結果が時間を経て再び元の要因へ影響する場合があります。
例えば、企業の価格政策、広告投資、生産能力、在庫管理、研究開発、人材育成などは、それぞれ独立した問題ではありません。
ある施策が短期的には有効でも、長期的には別の制約や問題を生み出す可能性があります。
システムダイナミクスは、こうした問題について、どのような関係構造がどのような時間変化を生み出すかを検討するための方法です。
この役割は、データの予測精度を高めることとは異なります。
例えば、機械学習によって来月の売上を高精度で予測できたとしても、価格や広告費を変更したときに売上がどのように変わるかを、その予測モデルだけで適切に判断できるとは限りません。
そのためには、施策と結果の因果関係についてのモデルが必要になります。
システムダイナミクスは、そのような因果的な仕組みを明示的に表現するための一つの方法です。
ただし、システムダイナミクスモデルが因果関係を図や方程式で表現しているからといって、その因果関係が実証されているとは限りません。
因果モデルを作ることと、因果モデルが正しいことは区別しなければなりません。
システムダイナミクスと機械学習の違い
システムダイナミクスと機械学習は、どちらもデータやモデルを利用しますが、問題への接近方法が異なります。
| 観点 | システムダイナミクス | 一般的な予測目的の機械学習 |
|---|---|---|
| 主な目的 | システムの仕組みと時間変化を説明する | データから予測規則を学習する |
| モデルの構造 | 因果仮説や蓄積構造を明示する | データと学習アルゴリズムに依存する |
| データの役割 | モデル構造やパラメータの検証・推定に利用 | 学習において中心的な役割を持つ |
| 介入策の分析 | 因果構造が適切なら施策の影響を検討できる | 単純な予測モデルでは介入の効果を保証できない |
| 主な弱点 | モデル構造や仮定が誤っている可能性 | 相関関係に依存し、因果的な解釈が難しい場合がある |
ここでいう機械学習は、主に一般的な予測モデルを指しています。
機械学習の中にも、因果推論、動的システムの同定、制御、物理法則を利用した学習などの研究分野があります。
そのため、システムダイナミクスと機械学習を単純に対立する方法として捉えることは適切ではありません。
むしろ、システムダイナミクスによって関係構造を記述し、機械学習によって一部の関係式やパラメータを推定するという組み合わせが考えられます。
実践例 ― 顧客サポートの処理能力をモデル化する
システムダイナミクスの具体的なモデルとして、顧客サポートの未処理件数を考えます。
未処理件数はストックです。
新規問い合わせは流入、対応完了は流出です。
まず、次の変数を設定します。
| 変数 | 内容 |
|---|---|
| 未処理問い合わせ件数 | 現在残っている対応案件の数 |
| 新規問い合わせ到着率 | 単位時間あたりの新規問い合わせ件数 |
| 対応完了率 | 単位時間あたりに完了する案件数 |
| 対応可能な担当者数 | 実際に対応業務を行える人数 |
| 一人あたりの処理能力 | 担当者一人が単位時間に処理できる案件数 |
| 採用・教育の遅れ | 増員を決定してから対応能力が増えるまでの期間 |
未処理件数の変化率は、次のように表せます。
[
\frac{dB(t)}{dt}=A(t)-C(t)
]
ここで、(B(t)) は未処理件数、(A(t)) は新規問い合わせ到着率、(C(t)) は対応完了率です。
対応完了率は、例えば、担当者数と一人あたりの処理能力によって制約されると考えられます。
ただし、実際には問い合わせの難易度、勤務時間、システムの性能、未処理件数の状態なども関係します。
さらに、未処理件数が増えると採用努力が増えるものの、採用・教育に時間がかかるという関係を追加します。
このようなモデルを用いれば、例えば次のような施策を比較できます。
| 施策 | 検討できる問題 |
|---|---|
| 担当者の増員 | 未処理件数をどの程度削減できるか |
| 教育期間の短縮 | 対応能力が増えるまでの遅れを減らせるか |
| 対応業務の自動化 | 一人あたりの処理能力を改善できるか |
| FAQの充実 | 問い合わせ到着率を削減できるか |
| 問い合わせ内容の改善 | 対応に必要な時間を減らせるか |
ここで注意したいのは、これらの施策の効果は、モデルの構造とパラメータに依存するということです。
例えば、FAQを充実させても、問い合わせ内容が複雑な場合には、到着率がほとんど減らない可能性があります。
また、対応の自動化によって処理能力が増える一方、回答品質が低下して再問い合わせが増える可能性もあります。
モデルを作る際には、このような代替的な関係も検討する必要があります。
システムダイナミクスの限界
システムダイナミクスには、現在でも重要な限界があります。
第一に、モデルの構造を決めることが難しいという問題があります。
例えば、ある企業の売上高を説明する際には、価格、広告、製品品質、競争、顧客満足度など、多数の要因が考えられます。
しかし、どの変数を含め、どの関係を設定するべきかは、自動的には決まりません。
第二に、パラメータの推定が難しい場合があります。
特に、観測できるデータが少ない場合や、複数のパラメータが似た影響を与える場合には、適切な値を求めにくくなります。
第三に、過去のデータを再現できても、将来の施策の効果を正しく予測できるとは限りません。
未知の状況では、過去とは異なる行動や因果関係が現れる可能性があります。
第四に、モデルの対象範囲を広げすぎると、構造とパラメータが複雑になり、検証が困難になる場合があります。
第五に、個々の主体の違いや、離散的な出来事が重要な問題では、通常の集約的なシステムダイナミクスモデルだけでは十分に表現できない場合があります。
第六に、シミュレーション結果が数値として示されることで、その精度や信頼性が実際よりも高く評価される危険があります。
モデルの精密さと、現実に対する正しさは別の問題です。
ThinkNaviにおけるシステムダイナミクスの位置づけ
ThinkNaviでは、システムダイナミクスを、システム思考や因果ループ図から、定量的なモデル分析へ進むための方法として位置づけます。
システム思考では、問題を相互依存する要素の全体として理解します。
因果ループ図では、変数間の因果関係とフィードバックを整理します。
システムダイナミクスでは、さらにストック、フロー、方程式、パラメータなどを定義し、時間変化をシミュレーションします。
このように、三つのページにはそれぞれ異なる役割があります。
| 方法 | 主な役割 |
|---|---|
| システム思考 | 相互依存、フィードバック、時間変化の考え方を理解する |
| 因果ループ図 | 因果仮説とフィードバック構造を可視化する |
| システムダイナミクス | 数理モデルによって時間変化や施策の影響を分析する |
ThinkNavi Freeでは、ストックとフローを手入力し、単純な蓄積モデルを作成してシミュレーションするツールが考えられます。
例えば、在庫量、顧客数、未処理問い合わせ件数などについて、流入率と流出率を設定し、時間変化を表示する機能です。
さらに、変数間の関係を追加し、フィードバックや時間の遅れを考慮することも考えられます。
ただし、最初から複雑なモデルを自由に構築できる汎用シミュレーション環境を開発する必要があるとは限りません。
基本的なストック・フローの構造を理解し、条件を変えて振る舞いを比較できるだけでも、教育的な価値があります。
LLM活用版で考えられる機能
LLMを利用する場合には、文章で説明された問題から、変数と関係の候補を抽出し、ストック・フロー構造を提案することが考えられます。
例えば、以下のような作業が可能になるかもしれません。
- 問題の文章から変数を抽出する。
- 変数をストック、フロー、補助変数などへ分類する。
- 因果関係と時間の遅れの候補を提案する。
- 数理モデルの草案を生成する。
- パラメータの設定や観測データとの照合を支援する。
- シミュレーション結果を説明し、異なる施策を比較する。
ただし、LLMが生成するモデルを自動的に正しいものと扱うべきではありません。
特に、ストックとフローの単位、関係式の意味、パラメータの出典、初期条件などを確認する必要があります。
また、シミュレーション結果から因果的な結論を導く場合には、そのモデル構造が妥当であることを検討する必要があります。
独自のシミュレーションエンジンは必要か
システムダイナミクスの基本的な計算は、微分方程式や差分方程式の数値計算です。
したがって、単純なモデルであれば、既存のプログラミング環境や数値計算ライブラリを利用して実装できます。
また、より本格的なモデルを扱う場合には、PySDなどの既存のシステムダイナミクス関連ライブラリや専用ソフトウェアとの連携が考えられます。
独自エンジンを開発する場合には、数値積分、時間の遅れ、配列変数、モデルの整合性、単位のチェックなど、必要な機能が増えます。
そのため、ThinkNaviの目的が思考技法の理解と利用支援であるなら、最初から専用ソフトウェアと同等の機能を開発するよりも、限られたモデルを確実に実行できる仕組みから始める方が適切な場合があります。
ConceptMinerとの関係
システムダイナミクスは、ConceptMinerのような知識探索・分析システムとも、将来的に関連する可能性があります。
例えば、技術文書や報告書から因果関係、制御関係、機能関係などを抽出し、特定のシステムについて動的なモデルを構築することが考えられます。
さらに、異なる技術システムの関係構造を比較することで、新しい制御方法や供給方式などの候補を探索できる可能性もあります。
ただし、類似した関係構造が見つかったからといって、それをそのままシステムダイナミクスモデルとして利用できるわけではありません。
ストックとフローの特定、関係式の作成、単位の確認、パラメータの推定などが必要です。
また、GNGによる概念的な近傍関係、構造写像理論による関係構造の対応づけ、システムダイナミクスによる因果的な時間変化のモデル化は、それぞれ異なる方法です。
これらを組み合わせることによって、情報の整理、異分野の仮説探索、動的なモデル分析へと進む可能性はあります。
しかし、その有効性を確認するには、具体的な対象と評価方法を設定する必要があります。
これらは将来の開発可能性を示すものであり、現在すべての機能が提供されていることを意味しません。
システムダイナミクスは古い技術なのか
システムダイナミクスは、確かに古い歴史を持つ方法論です。
ストックとフロー、フィードバック、時間の遅れを用いてシステムを表現するという基本原理も、長年にわたって維持されてきました。
しかし、その基本原理が古いことと、現在の技術として価値がないことは同じではありません。
近年は、観測データからのパラメータ推定、ベイズ的な不確実性分析、深層学習との統合、ハイブリッドシミュレーション、フィードバック構造の定量分析、LLMによるモデル構築支援などが進展しています。
一方で、モデル構造の設定や検証が難しいという問題は、現在も残っています。
特に、因果関係を示した数理モデルを構築できることと、そのモデルが現実の因果関係を正しく表現していることは、厳密に区別しなければなりません。
また、従来からある方法をAIで自動化しただけでは、新しい方法論が成立したとは限りません。
AIによってモデル構築の負担が軽減されても、モデルの解釈と検証には専門的な判断が必要です。
システムダイナミクスの近年の進展は、基本的な数理モデルを置き換えることではなく、モデルをデータから推定し、他の技術と組み合わせ、構築と検証を支援できるようになってきたことにあります。
関連ページ
- システム思考とは ― 相互依存、フィードバック、時間変化から問題を理解する
- 因果ループ図とは ― フィードバックの構造を可視化し、問題の振る舞いを理解する
- ロジカルシンキングとは ― 論理的に考え、筋道を説明し、相手の理解につなげる
- 問題構造化とは ― 問題を分解し、関係を明らかにして解決への道筋をつくる
- 根本原因分析(RCA)― 問題が発生する仕組みを解明し、再発を防ぐ
- KPIツリーとは ― 目標指標を分解し、改善のレバーを見つける
- 概念マップとは ― 概念間の関係を表現し、知識の構造を理解する
- 構造写像理論|異なる対象の関係構造を対応づけ、新しい推論を生み出す
- アナロジー(類推)とは ― 異なる領域の知識を結びつけ、新しい発想と仮説を生み出す
- 実験計画法(DOE)― 複数の要因とその交互作用を調べるための実験設計
- 統計学とは ― データから規則性を発見し、不確実な世界を理解する
- 多変量解析 ― 多くの変数から関係や構造を発見する統計的分析
- 定性と定量 ― 世界を理解する二つの視点とその統合
- シナリオプランニング|複数の将来を考える
- 批判的思考|主張と根拠を吟味する
- 思考の科学と哲学|考えることを問い直す
- 概念調査とは | 新しい概念と未知の可能性を発見する思考方法
参考文献・関連資料
基礎理論
- Jay W. Forrester, Industrial Dynamics, MIT Press, 1961.
- Jay W. Forrester, Urban Dynamics, MIT Press, 1969.
- Jay W. Forrester, World Dynamics, Wright-Allen Press, 1971.
- John D. Sterman, Business Dynamics: Systems Thinking and Modeling for a Complex World, Irwin/McGraw-Hill, 2000.
- Donella H. Meadows, Thinking in Systems: A Primer, Chelsea Green Publishing, 2008.
- Peter M. Senge, The Fifth Discipline: The Art & Practice of the Learning Organization, Doubleday, 1990.
近年の研究
- Asmeret Naugle, Saeed Langarudi, and Timothy Clancy, “What Is (Quantitative) System Dynamics Modeling? Defining Characteristics and the Opportunities They Create,” System Dynamics Review, 40(2), 2024.
- Hazhir Rahmandad, Ali Akhavan, and Mohammad S. Jalali, “Incorporating Deep Learning Into System Dynamics: Amortized Bayesian Inference for Scalable Likelihood-Free Parameter Estimation,” System Dynamics Review, 2025.
- John Hayward and Paul A. Roach, “A Comparison of Loop Dominance Methods: Measures and Meaning,” System Dynamics Review, 2024.
- Le Khanh Ngan Nguyen, Susan Howick, and Itamar Megiddo, “A Framework for Conceptualising Hybrid System Dynamics and Agent-Based Simulation Models,” European Journal of Operational Research, 315(3), 2024, pp. 1153–1166.
- Niyousha Hosseinichimeh et al., “From Text to Map: A System Dynamics Bot for Constructing Causal Loop Diagrams,” System Dynamics Review, 2024.
- William Schoenberg, “Building and Learning With Models Using AI,” System Dynamics Review, 42(1), 2026.
- William Schoenberg, “The Qualitative Engine: Creating and Evaluating an Iterative AI Modeling Tool,” System Dynamics Review, 42(2), 2026.
- “Graph Notation as a Gateway—Transitioning from Causal Loop to Stock and Flow Diagrams (and Beyond) in System Dynamics Modeling,” International Journal of Social Research Methodology, 2026.
- “Agent-Based Modeling and System Dynamics Integrated with AI and Analytical Methods: A Structured Review of Hybrid Approaches, Applications, and Future Directions for Decision Making in Complex Systems (2021–2026),” Systems, 14(8), 2026.